Przetwarzanie danych i optymalizacja wyszukiwania w Scali
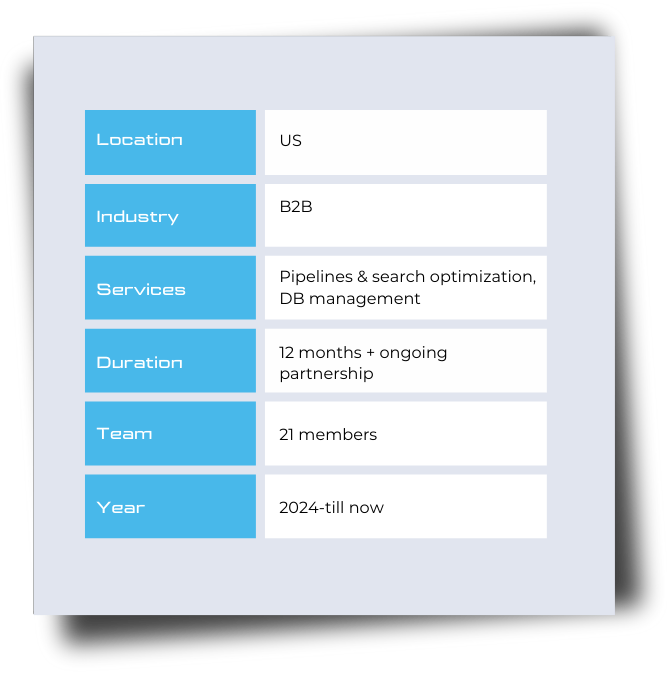
Nasz klient zmagał się z powolnymi i nieefektywnymi pipeline’ami, które nie nadążały za ogromnym napływem danych. Jego wyszukiwarka była zbyt wolna, zbyt mało elastyczna i niewystarczająco wydajna w stosunku do rosnących potrzeb. Pomimo wykorzystania Hive, HDFS i niestandardowych GlueJobs wydajność się nie poprawiała.
Nierównomierny rozkład danych był poważnym problemem — niektóre zadania Spark trwały znacznie dłużej niż inne, spowalniając przetwarzanie danych i zmniejszając wydajność pipeline’u. Po stronie wyszukiwania zapytania nie były zoptymalizowane. Mimo ustrukturyzowanych danych nieefektywne indeksowanie i partycjonowanie sprawiały, że wyszukiwanie trwało dłużej, niż oczekiwano.
Klient potrzebował w pełni zoptymalizowanego pipeline’u opartego na Scali, wykorzystującego strategie partycjonowania, indeksowania i buforowania, aby skrócić czas przetwarzania i przyspieszyć wyszukiwanie.
Kluczowe wyzwania w projekcie
Duże, nierównomiernie rozłożone zbiory danych
Pipeline’y klienta musiały codziennie pobierać, transformować i analizować terabajty danych, jednak nierównomierny rozkład danych sprawiał, że czas przetwarzania był nieprzewidywalny. Niektóre zadania kończyły się w kilka sekund, podczas gdy inne trwały znacznie dłużej. Zadania Spark nie były odpowiednio zbalansowane, co tworzyło wąskie gardła spowalniające cały workflow.
Szybkość wyszukiwania
Istniejąca wyszukiwarka nie była przystosowana do natychmiastowego zwracania wyników. Przeszukiwanie milionów rekordów trwało zbyt długo. Zapytania nie były zoptymalizowane, indeksowanie było ograniczone, a duże zbiory danych dodatkowo wydłużały czas odpowiedzi. Celem NannosTech było przebudowanie logiki wyszukiwania z wykorzystaniem inteligentnego partycjonowania, indeksowania i optymalizacji bazy danych.
Złożony stos technologiczny
Projekt musiał łączyć Scala, Spark, Python, Java, Hive, Airflow i AWS. Poszczególne komponenty przetwarzały dane z różną szybkością, a zarządzanie zależnościami pomiędzy wieloma frameworkami i rozwiązaniami do przechowywania danych dodatkowo zwiększało złożoność. Naszym zadaniem było więc połączenie wszystkich elementów w dobrze zorkiestrowany system obsługujący zarówno przetwarzanie w czasie rzeczywistym, jak i zadania wsadowe.
Etapy wdrażania optymalizacji pipeline’u danych i wyszukiwarki
Pipeline przetwarzania danych
Pipeline’y klienta działały wolno, zadania były rozdzielane nierównomiernie, a operacje shuffle generowały wysokie koszty. Aby rozwiązać te problemy, przebudowaliśmy workflow przetwarzania danych, wykorzystując optymalizacje Scala Spark. Zastosowaliśmy salting, aby zrównoważyć rozkład danych. Wspólne partycjonowanie i broadcast joins ograniczyły zbędne przenoszenie danych, a buforowanie i odpowiednia alokacja zasobów zwiększyły ogólną szybkość. Usprawnienia te skróciły czas wykonywania zadań i poprawiły responsywność całego systemu.
Wyszukiwarka
Zwiększyliśmy szybkość wyszukiwania dzięki wielopoziomowemu indeksowaniu i zoptymalizowanym strategiom partycjonowania. System indeksuje dane przed wykonaniem zapytań, co skraca czas skanowania. Zintegrowaliśmy Manticore Search, aby umożliwić indeksowanie w czasie rzeczywistym i wyszukiwanie pełnotekstowe. Dodatkowo dostroiliśmy procedury składowane, dzięki czemu zapytania są wykonywane natychmiast nawet przy milionach rekordów w systemie.
Orkiestracja komponentów
Wykorzystaliśmy Apache Airflow do orkiestracji wszystkich komponentów pipeline’u. Każdy etap — pozyskiwanie danych, transformacja, indeksowanie i przechowywanie — był zarządzany za pomocą skierowanych grafów acyklicznych (DAG), dzięki czemu workflow stały się modułowe i skalowalne. Wbudowany monitoring Airflow pozwolił nam śledzić czas wykonania, wykrywać awarie i uruchamiać alerty umożliwiające szybkie reagowanie. W ten sposób nasz zespół przekształcił wcześniej nieprzewidywalny system w w pełni kontrolowany, wysokowydajny pipeline danych.
Bliższe spojrzenie na kompletny pipeline danych
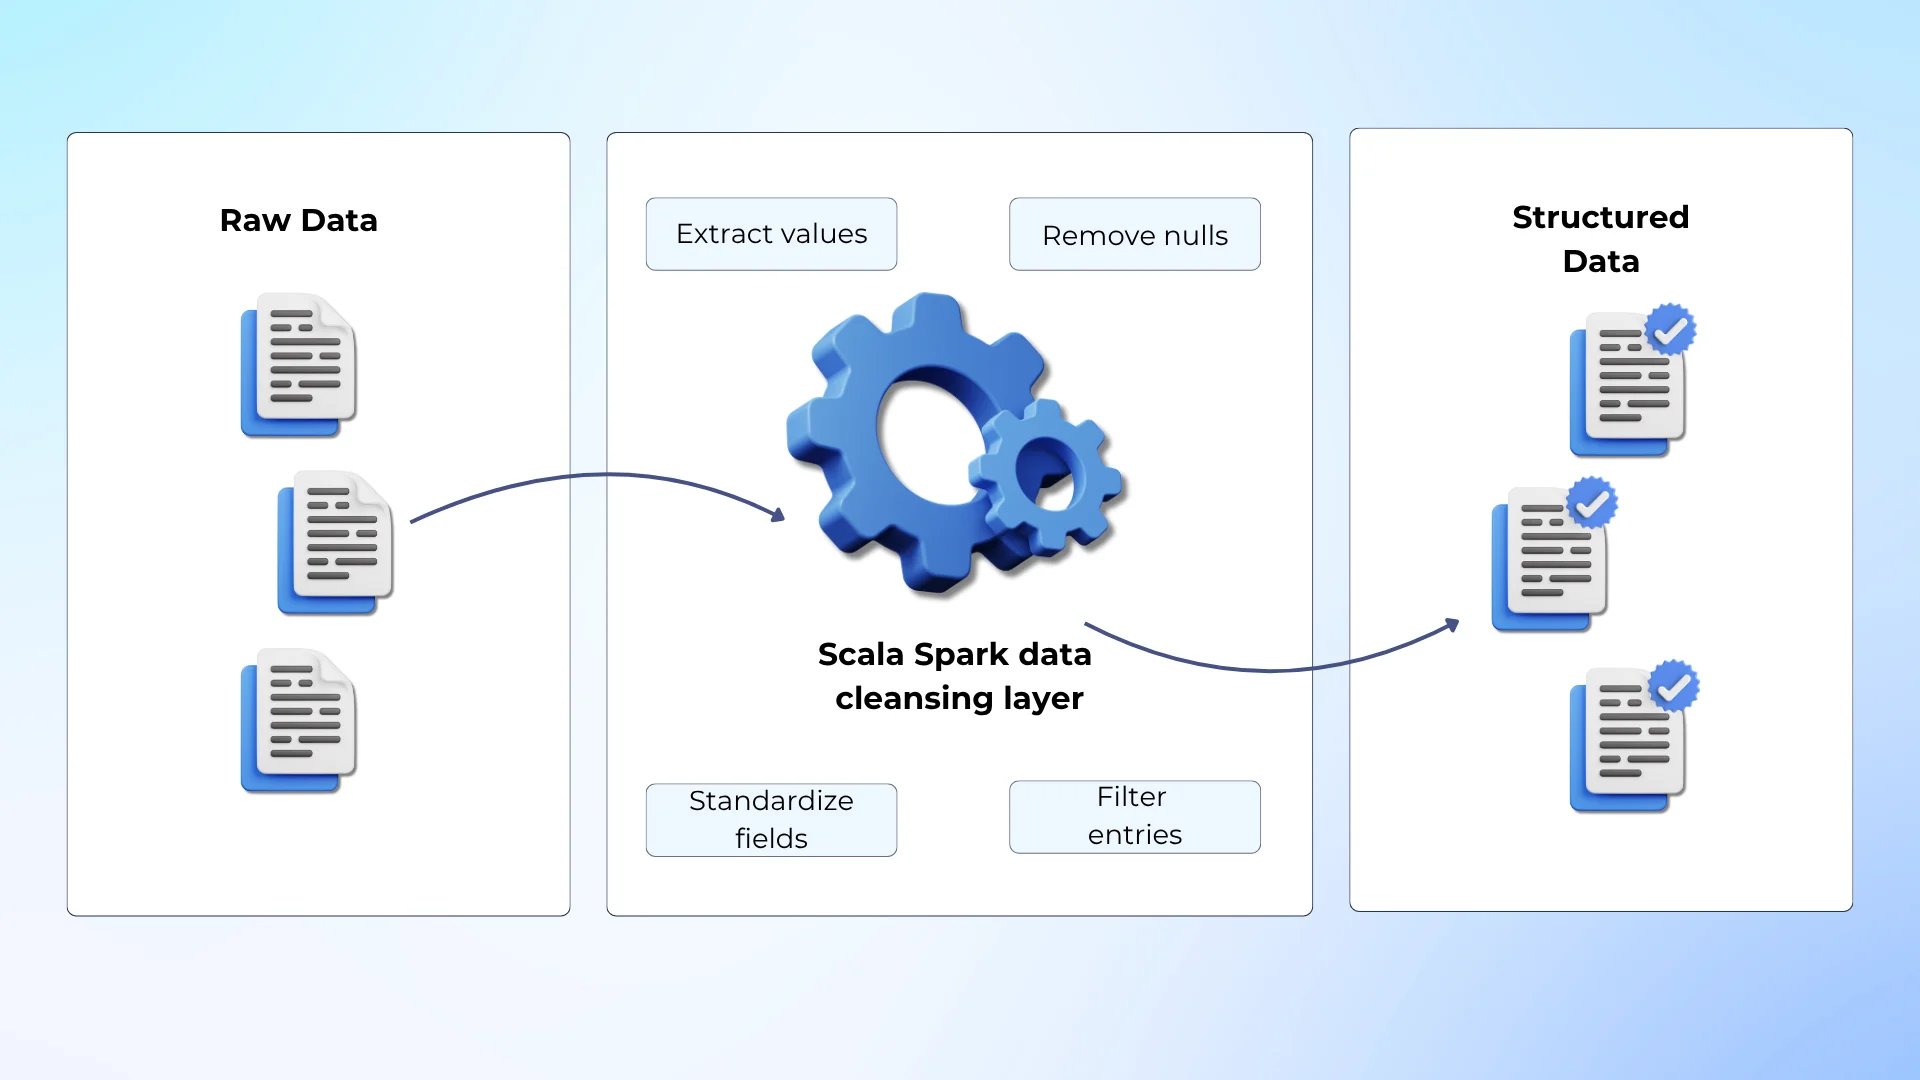
Nie można zbudować solidnego pipeline’u danych na danych niskiej jakości. Dlatego po pozyskaniu surowych danych musieliśmy je oczyścić. Zbudowaliśmy warstwę oczyszczania danych opartą na Scala Spark. Pipeline:
- Wyodrębniał kluczowe wartości z surowych zbiorów danych.
- Usuwał wartości null, poprawiał formaty i standaryzował pola.
- Filtrował zbędne rekordy, aby skrócić czas przetwarzania.
Po zakończeniu tego etapu pipeline zawierał ustrukturyzowane dane wysokiej jakości, gotowe do transformacji.
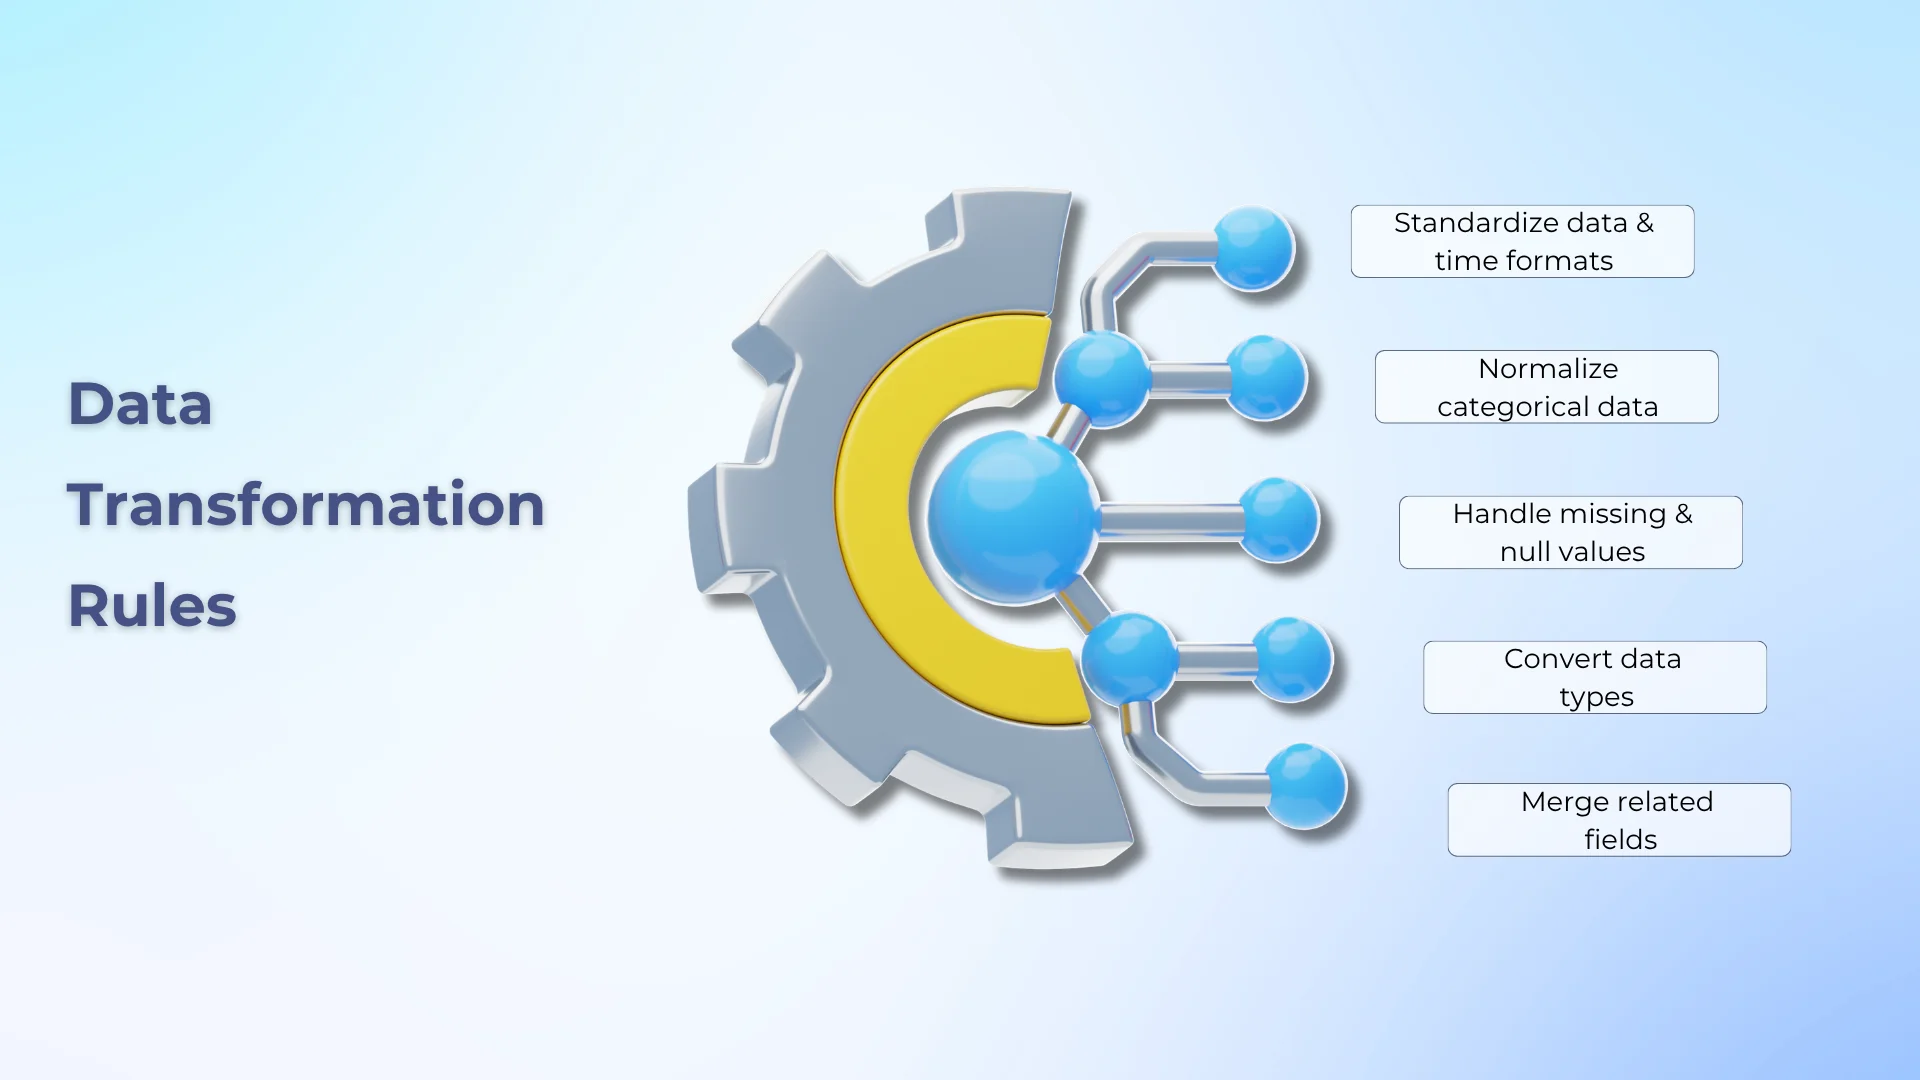
Zmapowaliśmy i przekształciliśmy surowe rekordy do ujednoliconego schematu, aby zapewnić kompatybilność w całym systemie. Obejmowało to:
- Stosowanie reguł transformacji w celu oczyszczania i standaryzacji wartości.
- Konwersję pól do spójnego formatu, aby różne zbiory danych mogły ze sobą współpracować.
- Wdrożenie ustrukturyzowanego modelu danych upraszczającego wykonywanie zapytań i przechowywanie.
Po zakończeniu tego etapu dane były oczyszczone, ustrukturyzowane i zoptymalizowane.
Po transformacji różne zbiory danych zostały połączone w finalny zbiór za pomocą:
- Operacji Group by umożliwiających logiczne grupowanie danych.
- Łączenia wielu zbiorów danych na podstawie wcześniej zdefiniowanych kluczy.
- Operacji Union służących do łączenia ustrukturyzowanych źródeł danych.
Na tym etapie pipeline zawierał ujednolicony zbiór danych zoptymalizowany pod kątem zapytań i gotowy do efektywnego przechowywania.
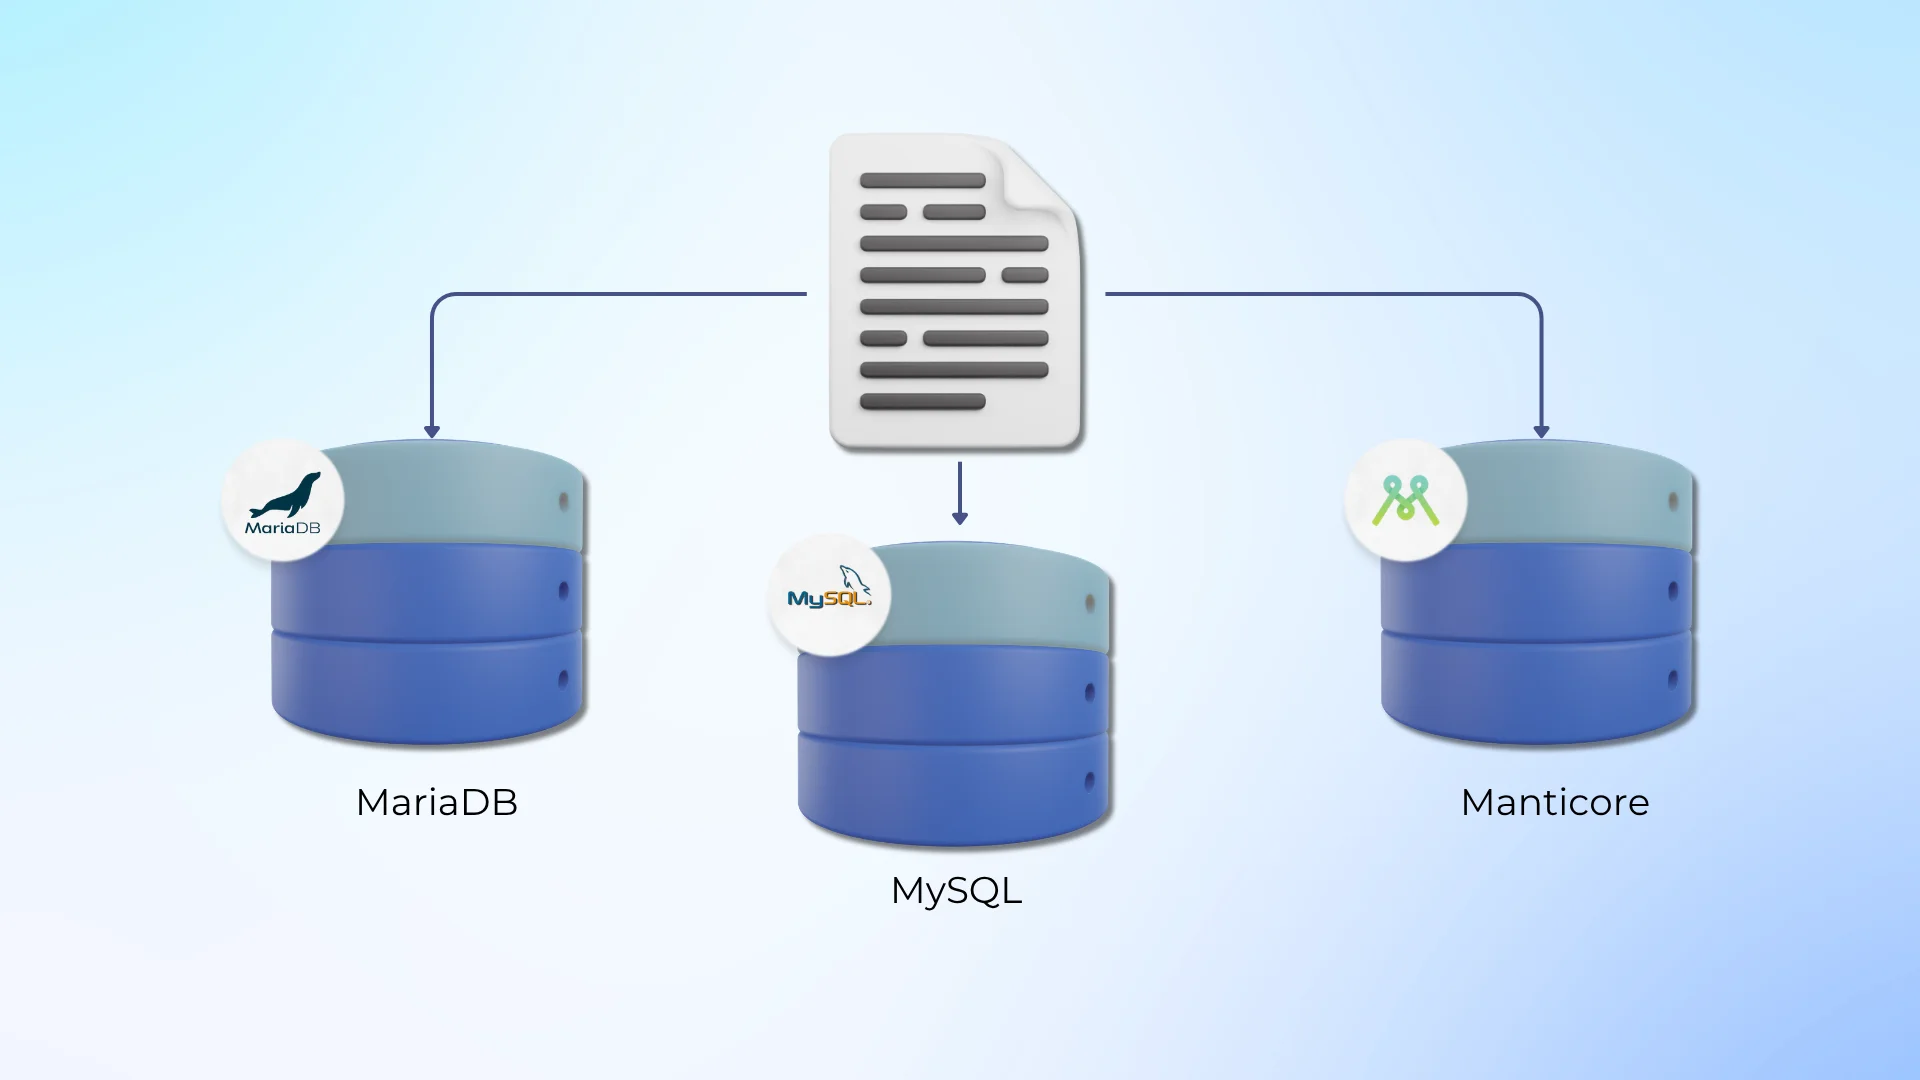
Klient potrzebował dostępu do ogromnych zbiorów danych bez opóźnień w wykonywaniu zapytań. Aby to osiągnąć, zoptymalizowaliśmy przechowywanie i wdrażanie danych poprzez:
- Partycjonowanie i indeksowanie bazy danych w celu przyspieszenia wyszukiwania.
- Wdrożenie procedur składowanych w MariaDB, MySQL i Manticore.
- Integrację wyszukiwarki zapewniającej szybkie zwracanie wyników.
Na tym etapie system był gotowy do obsługi dużego obciążenia zapytaniami, wspierając analitykę w czasie rzeczywistym i szybkie pobieranie danych.
Technologie wykorzystane w projekcie

Scala

C#
Java

Apache Spark
Apache Hive

Airflow

MariaDB
Manticore
MySQL

AWS
Rezultaty: krótszy czas przetwarzania i szybsze wyszukiwanie
Pomogliśmy klientowi wyeliminować wąskie gardła, przyspieszyć wyszukiwanie i skalować infrastrukturę. Silnik Scala Spark obsługuje teraz przetwarzanie rozproszone, równoważąc nierównomierne obciążenia za pomocą saltingu, współpartycjonowania i strategii buforowania. Zapytania wyszukiwania są wykonywane natychmiast dzięki zoptymalizowanemu partycjonowaniu, indeksowaniu i procedurom składowanym w Manticore, MariaDB i MySQL. Airflow orkiestruje workflow, zapewniając wykonywanie zadań, automatyczny monitoring i wykrywanie błędów w czasie rzeczywistym. System jest obecnie skalowalny, odporny na awarie i zoptymalizowany pod kątem złożonych zapytań wykonywanych na dużych zbiorach danych.
- Ponad 50% szybsze przetwarzanie dzięki optymalizacjom Spark
- Czas odpowiedzi wyszukiwania poniżej jednej sekundy dzięki indeksowanym polom i partycjonowanym zapytaniom
- Orkiestracja bez przestojów dzięki automatyzacji Apache Airflow
- Zoptymalizowane pobieranie danych dzięki ustrukturyzowanym procedurom w MariaDB i MySQL
- Skalowalność bez utraty wydajności, z obsługą milionów rekordów